Begin februari 2026 werkte Google de documentatie van Googlebot bij. De opvallendste wijziging: Googlebot crawlt maximaal 2MB HTML per pagina. Dat klinkt als een forse verlaging ten opzichte van de eerder gedocumenteerde 15MB. Toch verandert er voor vrijwel elke website niets, want Google heeft vooral opgeschreven wat Googlebot al deed.
Wat is er precies veranderd?
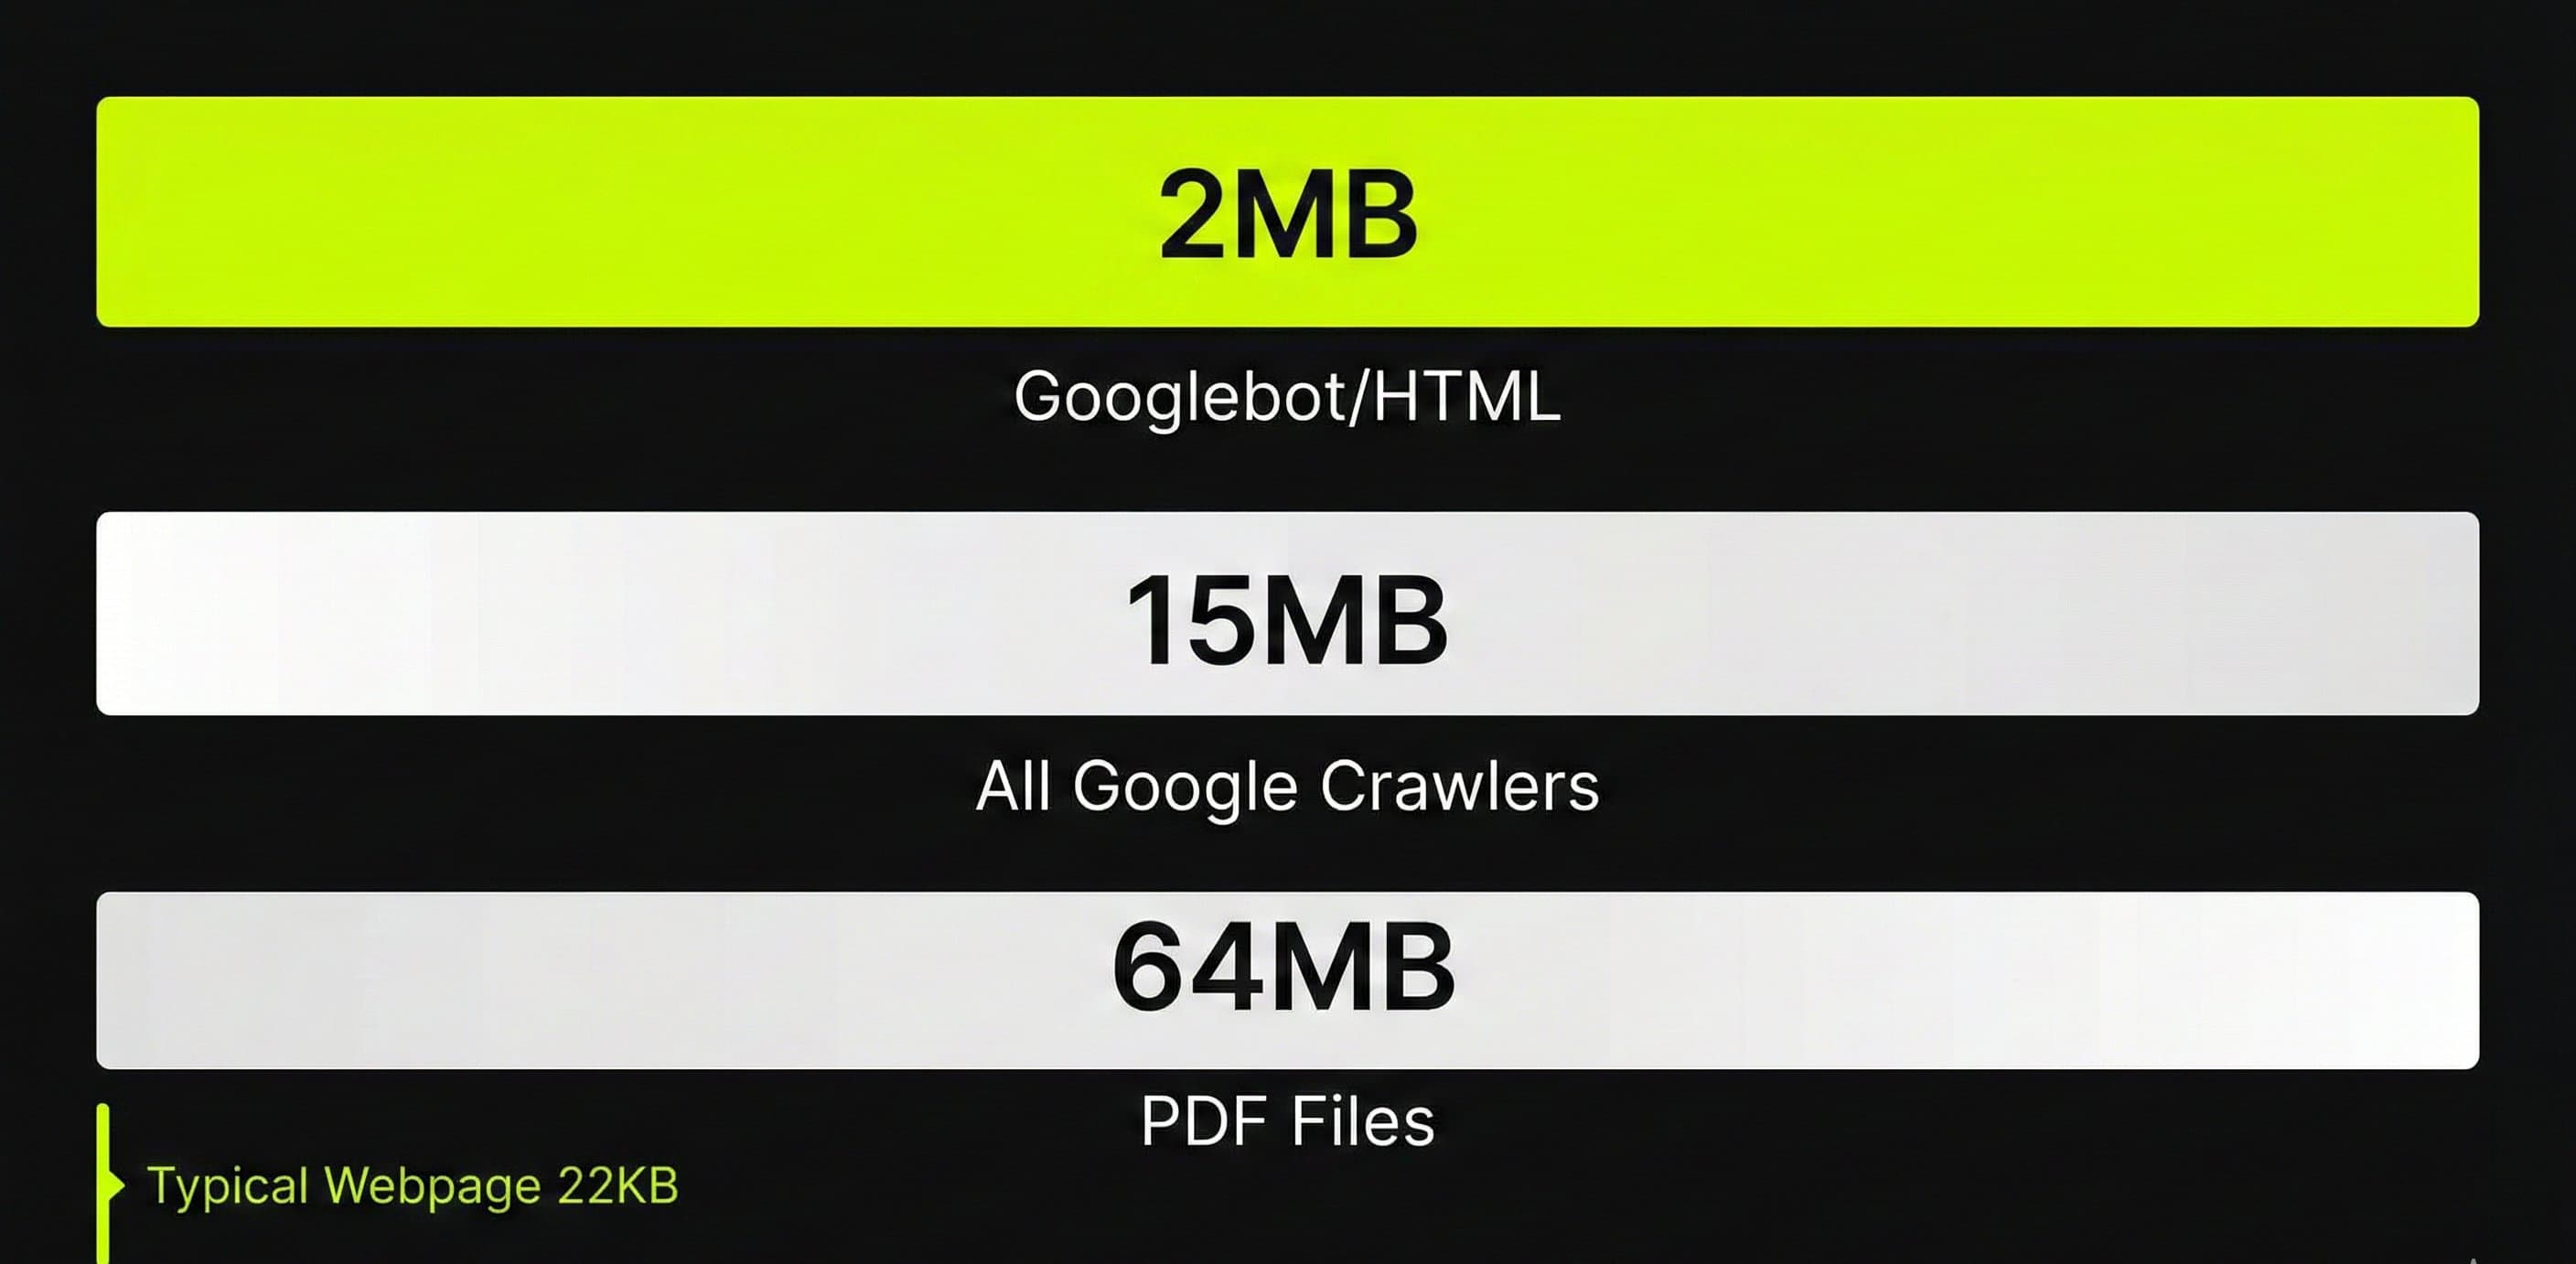
Op 4 februari 2026 verplaatste Google informatie over crawl-limieten van de Googlebot-documentatie naar de bredere crawler-documentatie. Tegelijk kwamen er specifiekere limieten bij voor Googlebot zelf. Daardoor staan er nu drie limieten in de documentatie, elk voor een ander onderdeel.
De drie Google crawl-limieten:
- 2MB voor HTML en ondersteunde bestandstypes (Googlebot specifiek, voor Google Search)
- 64MB voor PDF-bestanden (Googlebot specifiek)
- 15MB standaard voor alle Google crawlers en fetchers (inclusief AdsBot, Feedfetcher, etc.)
Google benadrukt zelf dat het gedrag niet is veranderd. Een woordvoerder van Google schreef op Bluesky: “None of these recently changed, we just wanted to document them in more detail.” De 2MB-limiet bestond waarschijnlijk al jaren, alleen stond hij nooit eerder apart beschreven.
Let wel op het verschil: Googlebot (de crawler voor Google Search) heeft een lagere limiet dan de andere crawlers van Google. De 15MB die sinds een blogpost van Google uit 2022 gedocumenteerd stond, gold voor alle crawlers samen. Nu is duidelijk dat Googlebot zelf strenger is.
Wat gebeurt er als je pagina groter is dan 2MB?
De documentatie van Google zegt het letterlijk: “Once the cutoff limit is reached, Googlebot stops the fetch and only sends the already downloaded part of the file for indexing consideration.”
Dat komt hierop neer:
- Googlebot stopt met downloaden zodra 2MB bereikt is
- Alleen het deel dat al binnen is, gaat door naar de indexering
- Alles na de 2MB-grens wordt genegeerd: niet gecrawld, niet geïndexeerd
- De limiet geldt voor de ongecomprimeerde data, niet voor de transfer size (wat er werkelijk over de lijn gaat)
Dat laatste punt vraagt even uitleg. Je server pakt de HTML waarschijnlijk in met gzip-compressie, zodat er minder data over de lijn gaat. Googlebot rekent alleen met de uitgepakte grootte. Een pagina die als 800KB binnenkomt, kan uitgepakt dus al boven de 2MB zitten.
Wat je kwijtraakt boven de 2MB
Hoeveel schade het doet, hangt af van waar je content in de HTML staat. Staan structured data, interne links of belangrijke tekst onderaan, en is de HTML daarvoor al groot, dan valt dat deel gewoon weg. Denk aan:
- Structured data (JSON-LD) die onderaan de pagina staat
- Interne links in de footer die niet meer gecrawld worden
- Productinformatie die pas later in de HTML verschijnt
- Rich results die verdwijnen omdat de schema markup gemist wordt
Moet je je zorgen maken?
Kort antwoord: waarschijnlijk niet. De mediane HTML-pagina is slechts 22KB (bron: Web Almanac 2025). Het 90e percentiel zit op circa 155KB. Om de 2MB-grens te bereiken, moet een pagina ongeveer 90 keer groter zijn dan een doorsnee pagina.
Ook volgens Google zelf komt het bijna nooit voor: “It's extremely rare that sites run into issues in this regard. 2MB of HTML is quite a bit. 90% of pages have less than 151kb HTML.”
2MB HTML is ongeveer 2 miljoen tekens. Dat is een boek van 400 pagina's op één webpagina. De gemiddelde bedrijfssite, blog of dienstenpagina komt daar niet in de buurt.
Vuistregel voor HTML-grootte:
- Onder 500KB: geen enkel probleem, en daar valt bijna elke website onder
- 500KB tot 1MB: veilig, maar hou de grootte in de gaten
- 1MB tot 2MB: slank de HTML af voordat de pagina verder groeit
- Boven 2MB: Google kapt je content af, dus pak dit meteen aan
Welke sites lopen wél risico?
Voor de meeste sites speelt de limiet dus niet. In drie situaties kan de 2MB-grens wel een echt probleem worden.
Webshops met productdata in de HTML
Sommige webshops stoppen duizenden productvarianten als JSON-data in de HTML, zodat de browser de pagina zelf opbouwt (client-side rendering). Een categoriepagina met 500 producten en al hun eigenschappen in zo'n JSON-blok komt dan makkelijk boven de 2MB uit.
Single page applications met grote JavaScript-bundels
Sommige single page applications (SPA's) zetten hun volledige applicatiecode als inline JavaScript in de HTML. Een moderne JavaScript-bundel is gecomprimeerd al snel honderden kilobytes groot, en uitgepakt kan dat oplopen tot meerdere megabytes. Laad je CSS en JavaScript als aparte bestanden, dan geldt voor elk van die bestanden dezelfde 2MB-limiet.
Pagina's met volledige datasets
Ook vergelijkingspagina's, prijslijsten en interactieve tools laden soms hun complete dataset mee in de eerste HTML. Bouw je bijvoorbeeld een financiële vergelijkingssite met duizenden tarieven in de pagina zelf, dan loopt dat snel op.
Valt je site in geen van deze drie groepen, dan hoef je je over de 2MB-grens geen zorgen te maken.
Hoe check je de HTML-grootte van je pagina's?
Of je site binnen de limiet zit, lees je af aan de ongecomprimeerde HTML-grootte. Die kun je op vier manieren meten.
Chrome DevTools
Open je pagina in Chrome, druk F12, ga naar het Network-tabblad en herlaad de pagina. Zoek het HTML-document (meestal het eerste item) en bekijk de kolom “Size”. Let op dat je de ongecomprimeerde grootte bekijkt, niet de transfer size. Klik op het document en bekijk de Response headers voor de volledige grootte.
Screaming Frog
Crawl je site met Screaming Frog SEO Spider. De kolom “Size” toont de ongecomprimeerde grootte per URL. Filter op pagina's groter dan 1MB, dan zie je meteen welke pagina's in de buurt van de grens komen.
Tame the Bots Fetch & Render
Tame the Bots heeft een Fetch & Render tool die het afkappen bij 2MB nabootst. Je ziet precies wat Googlebot wel en niet van je pagina zou zien. Op 6 februari 2026 raadde iemand van Google de tool aan op Bluesky.
Via de paginabron
De snelste check: rechtermuisklik op je pagina, “Paginabron weergeven”, selecteer alles (Ctrl+A), kopieer naar een teksteditor en sla het op als bestand. De bestandsgrootte is je ongecomprimeerde HTML-grootte.
Zo houd je je HTML onder de 2MB
Ook ver onder de limiet is lichte, opgeruimde HTML de moeite waard. Googlebot crawlt je site er efficiënter door, en het hoort bij goede technische SEO.
- Gebruik externe stylesheets en scripts. Inline CSS en JavaScript tellen mee voor de HTML-grootte. Externe bestanden worden apart gecrawld, elk met hun eigen 2MB-limiet.
- Vermijd inline JSON-datasets. Laad productdata, prijslijsten of andere grote datasets via een API, in plaats van ze in de eerste HTML mee te sturen.
- Zet structured data bovenaan. Gebruik je JSON-LD schema markup, zet dat dan in de head of vroeg in de body. Wordt de pagina afgekapt, dan heeft Googlebot de structured data al binnen.
- Zet belangrijke content vroeg in de HTML. Google geeft zelf dit advies: “Make sure to have important stuff in a reasonable place, and not only on the bottom.”
- Pagineer lange lijsten. Heb je een categoriepagina met 500 producten, splits die dan op in pagina's van bijvoorbeeld 50. Bezoekers vinden zo sneller wat ze zoeken, en Googlebot krijgt kleinere pagina's te lezen.
- Verwijder overbodige HTML. Denk aan inline styles die je CMS zelf aanmaakt, dubbele wrapper-divs en code die nergens meer voor dient. Ook die tekens tellen mee voor de 2MB.
Wat de limiet met crawl budget te maken heeft
De bestandslimiet en crawl budget hebben met elkaar te maken, maar het zijn twee verschillende dingen. Crawl budget bepaalt hoeveel URL's Googlebot kan en wil crawlen van je site. De bestandslimiet bepaalt hoeveel van een individuele pagina Google leest.
De relatie is indirect: grotere bestanden kosten meer bandbreedte en tijd per crawl. Als elke pagina op je site 1,5MB HTML is, kan Googlebot minder pagina's crawlen in dezelfde tijdspanne dan wanneer ze elk 50KB zijn. Google zegt zelf: “If Google can load and render your pages faster, they might be able to read more content from your site.”
Volgens de eigen handleiding van Google over crawl budget speelt het vooral bij sites vanaf zo'n 10.000 pagina's waarvan de inhoud dagelijks verandert. Kleinere sites hoeven er zelden over na te denken. Voor grote webshops met honderdduizenden URL's telt die efficiëntie wél.
Wat je moet onthouden over de 2MB-limiet
De 2MB-limiet is geen nieuwe beperking. Google heeft bestaand gedrag duidelijker beschreven in de documentatie. De 15MB geldt nog steeds voor Google's crawlers in het algemeen. De 2MB is specifiek voor Googlebot bij het crawlen voor Google Search.
Voor bijna elke website verandert er niets. Een doorsnee pagina is 22KB, en ook een uitgebreide productpagina of een lang blogartikel blijft ver onder de 2MB. De grens gaat pas tellen als je werkt met grote inline datasets, zware SPA's of pagina's die een volledige productcatalogus in de HTML meesturen.
Wil je er toch mee aan de slag, houd je HTML dan licht, zet belangrijke content en structured data vroeg in je broncode en laad stylesheets en scripts als aparte bestanden. Die stappen horen sowieso bij goede technische SEO.
Een technische check van je site
In een technische check kijk ik hoe Google je site crawlt en hoe snel je pagina's laden. Bel me op 06 282 064 10, of plan een gesprek.
PLAN EEN GESPREK